Amazon Web Services (AWS) est la plateforme de cloud computing leader mondial, utilisée par des millions d'organisations, de la startup au Fortune 500. Comprendre l'architecture AWS est essentiel pour quiconque conçoit des solutions cloud scalables, fiables et sécurisées. Elle regroupe les principes de conception, les patterns d'intégration de services et les stratégies d'organisation d'infrastructure qui permettent de bâtir des applications de classe mondiale dans le cloud.
Ce guide complet explore les fondamentaux de l'architecture AWS, les grandes catégories de services, les bonnes pratiques d'architecture et des patterns d'implémentation concrets. Que vous débutiez dans le cloud ou que vous architecturiez des solutions à l'échelle de l'entreprise, ce guide vous donne les clés pour prendre des décisions architecturales éclairées et concevoir des implémentations AWS solides.
Qu'est-ce que l'architecture AWS ?
Définition
L'architecture AWS désigne la conception et l'organisation d'une infrastructure cloud bâtie sur Amazon Web Services. Elle englobe le choix des services à utiliser, la façon dont ils s'intègrent, la circulation des données entre les composants, ainsi que la manière dont les systèmes montent en charge, assurent leurs performances et restent sécurisés.
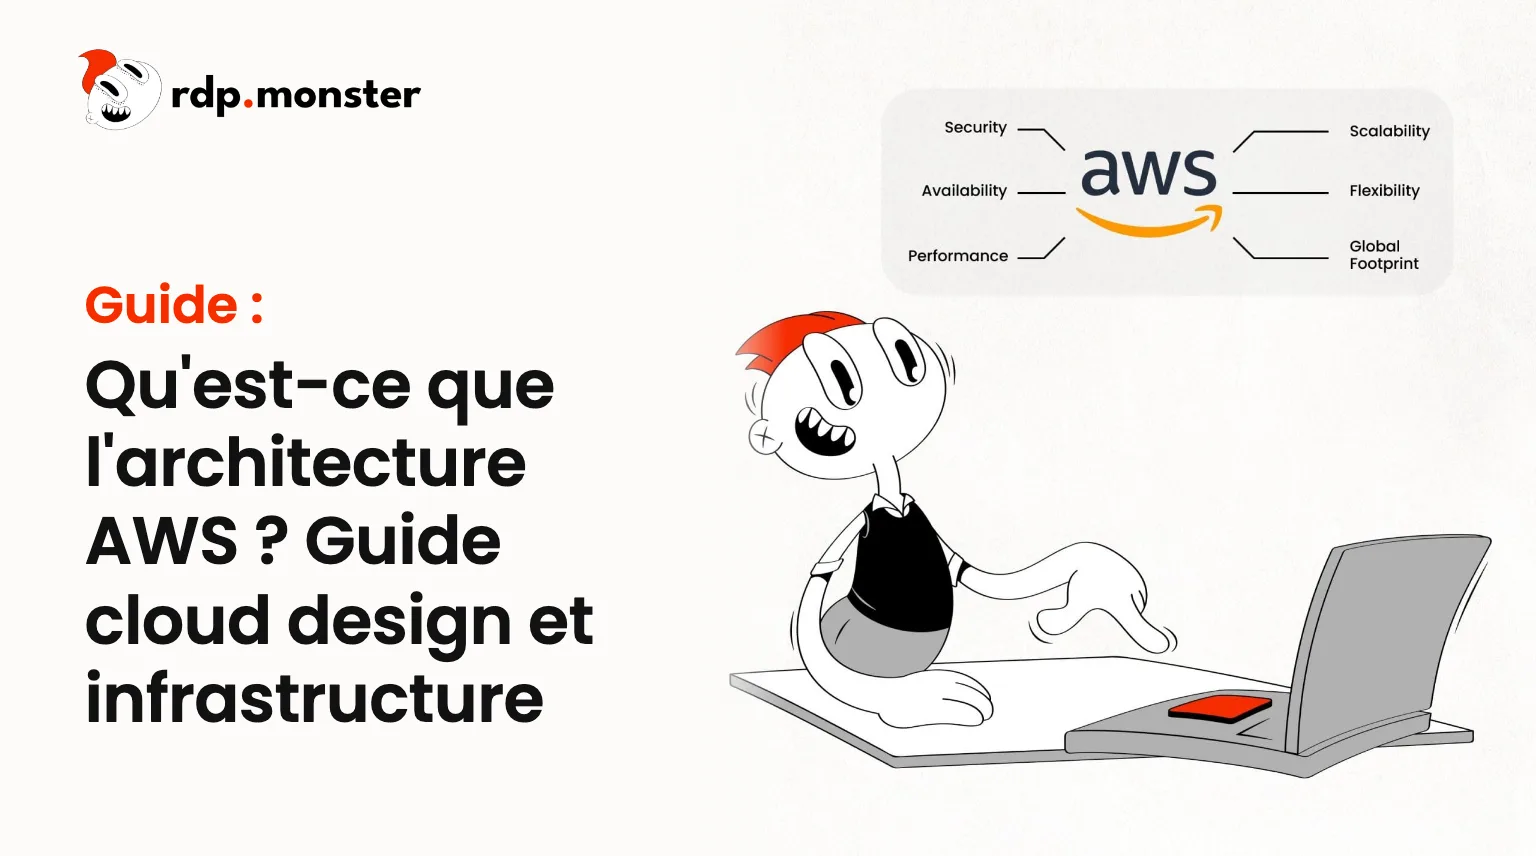
Une architecture AWS efficace équilibre plusieurs exigences concurrentes :
Performance : Répondre aux exigences de réactivité des applications
Scalabilité : Absorber la croissance sans refonte de l'architecture
Fiabilité : Maintenir la disponibilité malgré les pannes
Sécurité : Protéger les données et les applications contre les accès non autorisés
Maîtrise des coûts : Optimiser les dépenses sans sacrifier les exigences
Excellence opérationnelle : Permettre une gestion et un monitoring efficaces
Contrairement à l'infrastructure on-premises traditionnelle qui exige une planification de capacité fixe, l'architecture AWS exploite l'élasticité du cloud et le pay-as-you-go pour ajuster l'infrastructure au plus près des besoins applicatifs.
Principes architecturaux fondamentaux
1. Concevoir pour la panne
Les systèmes cloud connaissent inévitablement des pannes de composants. Une architecture efficace part du principe que les défaillances surviendront et les conçoit pour une dégradation gracieuse :
Redondance : Répartissez les charges de travail sur plusieurs zones de disponibilité, afin qu'aucun point de défaillance unique ne puisse mettre le système hors service.
Vérifications de santé : Mettez en place un monitoring qui détecte les composants défaillants et détourne automatiquement le trafic des instances en mauvaise santé.
Résilience : Concevez des applications capables de tolérer l'indisponibilité temporaire des services dont elles dépendent.
Sauvegarde des données : Conservez plusieurs copies des données sur des sites géographiquement répartis.
2. Couplage faible
Les systèmes fortement couplés tombent en panne dès qu'un composant individuel échoue. Le couplage faible via communication asynchrone garantit que les pannes restent localisées :
Files de messages : Découplez les services avec SQS ou SNS
Architecture événementielle : Les services réagissent à des événements plutôt qu'à des appels directs
Contrats d'API : Définissez des interfaces claires qui garantissent l'indépendance des services
Microservices : Décomposez les systèmes monolithiques en services déployables indépendamment
3. Élasticité et auto-scaling
L'avantage majeur du cloud, c'est l'allocation élastique des ressources (ajouter de la capacité pendant les pics, la retirer pendant les creux) :
Groupes Auto Scaling : Ajustez automatiquement le nombre d'instances en fonction de la demande
Répartition de charge : Distribuez le trafic sur plusieurs instances
Scaling de base de données : Utilisez des réplicas en lecture et le sharding pour faire évoluer la couche de données
Services serverless : Montée en charge automatique, sans planification de capacité
4. Penser en parallèle
Le traitement multi-thread et distribué accélère les charges de travail :
Calcul distribué : Traitez de grands jeux de données en parallèle sur plusieurs machines
Traitement concurrent : Gérez plusieurs requêtes simultanément
Parallélisme de données : Traitez simultanément différentes portions des données
Parallélisme de pipeline : Exécutez simultanément les différentes étapes du traitement
Services AWS principaux par catégorie
Services de calcul
EC2 (Elastic Compute Cloud) : Machines virtuelles offrant contrôle granulaire et flexibilité de configuration.
Lambda : Fonctions serverless qui exécutent du code sans gestion de serveur, en ne payant que le temps d'exécution.
ECS (Elastic Container Service) : Orchestration de conteneurs qui simplifie le déploiement applicatif.
Auto Scaling : Ajuste automatiquement les ressources selon la demande et les métriques.
Services de stockage
S3 (Simple Storage Service) : Stockage objet hautement disponible, adapté à des volumes de données quasi illimités.
EBS (Elastic Block Store) : Volumes de stockage bloc attachés aux instances EC2.
EFS (Elastic File System) : Système de fichiers réseau scalable pour accès concurrents.
Glacier : Stockage d'archives long terme avec fréquence de récupération minimale.
Calcul : Lambda pour les fonctions Stockage : S3 pour le stockage objet Base de données : DynamoDB pour la persistance des données APIs : API Gateway pour les points de terminaison HTTP
Scalabilité et élasticité
Scaling vertical
Augmentez la capacité d'une instance individuelle (CPU et mémoire plus puissants) :
Avantages : simple, conserve une seule instance
Inconvénients : downtime requis, limites matérielles, inefficacité des coûts
Cas d'usage : atténuation temporaire, petites charges
Scaling horizontal
Augmentez le nombre d'instances pour répartir la charge :
Avantages : pas de downtime, scale théoriquement illimité, coût efficient
Inconvénients : complexité, exige une conception sans état
Cas d'usage : charges croissantes, exigences de haute disponibilité
Mise en œuvre de l'auto-scaling
Scaling basé sur les métriques : Ajustez la capacité en fonction des métriques CloudWatch (CPU, mémoire, réseau)
Scaling planifié : Anticipez les variations prévisibles de la demande
Suivi de cible : Maintenez une métrique au niveau souhaité
Scaling de base de données
Réplicas en lecture : Répartissez le trafic de lecture sur plusieurs instances
Sharding : Partitionnez les données entre les instances selon une clé
DynamoDB : Scaling automatique dans des limites définies
Architecture sécurité et conformité
Sécurité réseau
Conception du VPC : Isolez les ressources dans des sous-réseaux privés inaccessibles depuis Internet
Security groups : Pare-feu au niveau de l'instance qui contrôle le trafic
ACL réseau (NACL) : Pare-feu au niveau du sous-réseau qui ajoute une couche de sécurité supplémentaire
VPN/Direct Connect : Connexions privées chiffrées vers AWS
Sécurité des données
Chiffrement au repos : Chiffrement KMS pour les bases de données et le stockage
Chiffrement en transit : TLS pour tous les transferts de données
Contrôle d'accès : Politiques IAM qui limitent l'accès aux données
Classification des données : Des niveaux de protection adaptés à la sensibilité de chaque type de données
Conformité
Normes réglementaires : AWS maintient sa conformité aux normes HIPAA, PCI-DSS, SOC 2, etc.
Pistes d'audit : CloudTrail journalise tous les appels d'API pour les contrôles de conformité
Clés de chiffrement : KMS permet la gestion et la rotation des clés de chiffrement
Évaluations régulières : Audits de sécurité et tests d'intrusion
Reprise après sinistre et continuité d'activité
Objectif de temps de reprise (RTO)
À quelle vitesse les systèmes doivent reprendre après une panne. Stratégies d'architecture AWS :
RTO faible : Configuration multi-région actif-actif offrant un failover immédiat RTO moyen : Snapshots réguliers permettant une reprise rapide RTO élevé : Acceptable pour les systèmes non critiques
Objectif de point de reprise (RPO)
Perte de données maximale acceptable. Décisions d'architecture :
RPO quasi nul : Réplication synchrone vers une autre région RPO de quelques minutes : Snapshots réguliers de la base de données RPO de quelques heures : Sauvegardes quotidiennes
Stratégies de sauvegarde
Snapshots automatisés : Snapshots EBS réguliers stockés dans S3
Réplication interrégions : Copiez automatiquement les données d'une région à l'autre
AWS Backup : Gestion centralisée des sauvegardes pour l'ensemble des services
Restauration à un instant donné : Restaurez les bases de données à n'importe quel point antérieur
Stratégies d'optimisation des coûts
Choix des instances
Instances réservées : Remise de 30 à 70 % en échange d'un engagement de capacité
Instances Spot : Jusqu'à 90 % de remise pour les charges tolérantes aux pannes
À la demande : Paiement à l'usage pour les charges imprévisibles
Savings Plans : Modèle de remise flexible
Optimisation du stockage
Hiérarchisation S3 : Déplacez les données rarement consultées vers des niveaux de stockage moins chers
Politiques de cycle de vie : Archivez ou supprimez automatiquement les anciennes données
Compression : Réduisez les besoins en stockage
Déduplication : Éliminez les données redondantes
Optimisation du calcul
Right-sizing : Analysez l'utilisation réelle et ajustez les types d'instances
Instances réservées : Engagement de capacité pour les charges prévisibles
Scaling planifié : Réduisez la capacité pendant les périodes de faible demande
Capacité réservée : Achetez à l'avance de la capacité de base de données à prix réduit
Pourquoi les organisations choisissent l'architecture AWS
Les organisations du monde entier adoptent AWS pour ses avantages fondamentaux :
Scalabilité : Passez du stade de startup à des opérations mondiales sans contraintes d'infrastructure
Fiabilité : Des SLA de disponibilité à 99,99 % adossés à l'infrastructure AWS
Sécurité : Conformité et certifications de sécurité de niveau entreprise
Présence mondiale : Déployez vos applications dans plus de 30 régions à travers le monde
Maîtrise des coûts : Payez uniquement ce que vous utilisez ; réduisez la capacité pour minimiser les coûts
Innovation : Innovation continue des services sans la responsabilité du self-hosting
Gérer une infrastructure AWS via RDP et l'accès à distance
De nombreuses organisations gèrent leur infrastructure AWS via des connexions Bureau à distance et SSH, en particulier pour :
Gestion de la console web depuis des emplacements distants
Outils d'administration sur des centres de contrôle Windows
Administration de serveurs d'application
Interfaces de gestion de bases de données
Tableaux de bord de monitoring et d'alerte
Gestion professionnelle d'infrastructure AWS
RDP.Monster fournit des solutions intégrées pour la gestion de l'infrastructure AWS :
Serveurs d'administration Windows
Accès distant pour la gestion de la console AWS
Hébergement d'outils d'administration
Serveurs de tableaux de bord de monitoring
Contrôle centralisé de l'infrastructure
Serveurs Linux/Unix pour AWS
Accès SSH pour gestion en ligne de commande
Développement et tests de Lambda
Automatisation d'infrastructure via scripts shell
Hébergement d'API Gateway
Solutions VPS optimisant les opérations AWS
Ressources dédiées pour les outils de gestion AWS
Connectivité fiable pour l'accès distant
Failover automatisé pour la continuité d'activité
Localisations serveur globales alignées sur les régions AWS
L'architecture AWS, c'est l'art et la science de concevoir des applications et des infrastructures cloud à la fois scalables, fiables, sécurisées, performantes et économiques. Le Well-Architected Framework fournit des repères éprouvés ; le catalogue très varié de services AWS permet de répondre à pratiquement toutes les exigences de conception.
Une architecture AWS efficace exige de comprendre les capacités des services, de reconnaître les patterns de conception et de faire des arbitrages éclairés entre priorités concurrentes. Les organisations qui réussissent affinent continuellement leur architecture par monitoring, analyse et expérimentation, exploitant tout le potentiel d'AWS tout en maîtrisant les coûts.
À mesure que l'adoption du cloud s'accélère et que les architectures gagnent en complexité, s'associer à des fournisseurs d'infrastructure qui maîtrisent à la fois AWS et les exigences opérationnelles des entreprises devient un atout majeur.
Vous construisez une infrastructure AWS d'entreprise qui exige une gestion robuste et un support opérationnel ? RDP.Monster fournit des solutions intégrées pour l'exploitation et la gestion de l'infrastructure AWS. Découvrez dès aujourd'hui notre infrastructure complète de gestion AWS.
Hébergement VPS Linux performant
Bénéficiez d'un contrôle total et de performances fulgurantes avec nos VPS Linux. Parfait pour héberger des applications, gérer des serveurs et optimiser votre workflow.
Quelle est la différence entre Régions AWS et Zones de disponibilité ?
Les régions sont des zones géographiques contenant plusieurs datacenters isolés (zones de disponibilité).
Déployez sur plusieurs AZ d'une même région pour la résilience ; sur plusieurs régions pour la reprise après sinistre.
Faut-il utiliser EC2 ou Lambda ?
Utilisez Lambda pour les charges imprévisibles, événementielles et aux exigences simples.
Utilisez EC2 pour les services à longue durée d'exécution nécessitant un contrôle fin et de la personnalisation.
Comment éviter que les coûts AWS dérapent ?
Utilisez AWS Budgets pour les alertes, Trusted Advisor pour les recommandations, les instances réservées pour les charges prévisibles, et faites des revues de coûts régulières.
Quelle est la meilleure approche pour un déploiement multi-région ?
Actif-passif pour la reprise après sinistre (bascule à la demande) ; actif-actif pour la haute disponibilité (traitement distribué).
Synchronisez les données de manière adaptée à chaque approche.
Comment concevoir pour répondre aux exigences de conformité AWS ?
Appuyez-vous sur la documentation de conformité AWS, chiffrez partout, conservez des pistes d'audit, évaluez régulièrement vos configurations et utilisez les ressources de conformité d'AWS.
Quelle est la différence entre RDS et DynamoDB ?
RDS est relationnel (données structurées, requêtes complexes) ; DynamoDB est NoSQL (non structuré, requêtes simples, échelle extrême).
À quelle fréquence faut-il sauvegarder les ressources AWS ?
La fréquence dépend du RPO. Les applications critiques exigent une réplication quasi continue ; pour les systèmes moins critiques, des snapshots quotidiens peuvent suffire.
Puis-je migrer facilement des applications existantes vers AWS ?
AWS Database Migration Service, Application Discovery Service et Server Migration Service facilitent la migration.
Comptez 3 à 6 mois pour les applications complexes.
Ingénieur systèmes avec plus de 10 ans d'exploitation de parcs Windows Server et Linux. Adrien gère la documentation infrastructure de rdp.monster et rédige nos guides sur le RDP, l'hébergement VPS, l'administration serveur, le réseau et les outils de confidentialité.
Nous utilisons des cookies pour améliorer votre expérience de navigation, proposer des publicités ou contenus personnalisés et analyser notre trafic. En cliquant sur « Accepter », vous consentez à notre utilisation des cookies.